您的购物车目前是空的!
TinyDC Token-FREE:本地词元一体机柜与 AI-Router 多模型聚合平台
方案概述
TinyDC Token-FREE 是面向团队、实验室与分支机构的 桌面级/机房级迷你数据中心 :一个 8U 10 英寸机柜 ,内含 4 台 ASUS Ascent GX10、1 台 OpenMesh MV-4Q 400G 交换机、管理网络与网关主机,出厂预装 多模型聚合词元管控平台(简称 AI-Router) ,开机即可提供词元(Token)服务。
- Token-FREE :本地以 4 路张量并行(TP4)运行完整 GLM-5.3(753B) ,日常请求的边际 Token 成本为零,数据不出机柜;
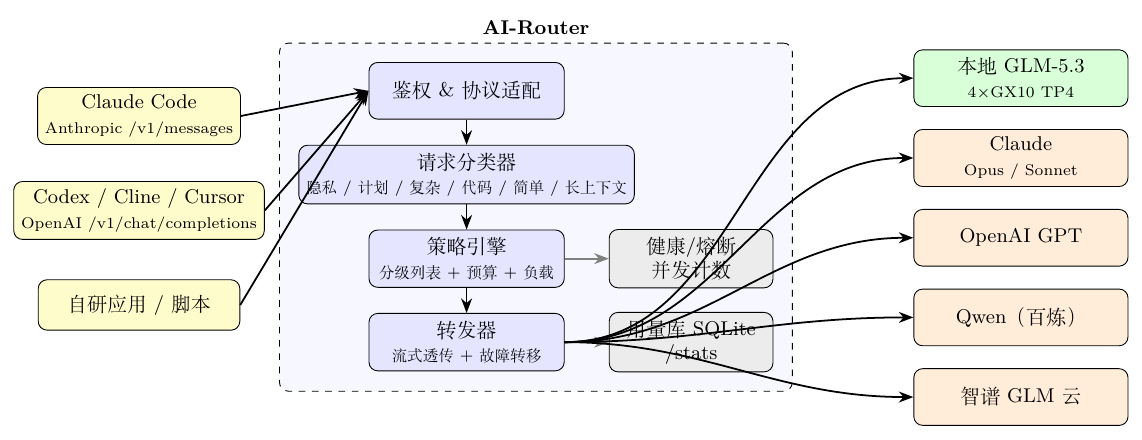
- 网络 :MV-4Q 以 400G 光互联(2 个 400G 口各拆分为 2×200G,每台主机 1 根 200G 线缆,RoCE 无损)构成计算底座;AI-Router 在其上对词元流量做分级调度与控制;
- 聚合 :复杂任务、计划类任务由 AI-Router 路由到 Anthropic、OpenAI、Qwen、智谱 GLM 等云端模型,本地过载、故障、超长上下文、预算耗尽时自动溢出与故障转移。
AI-Router 同时提供 OpenAI 与 Anthropic 兼容接口,客户端(Claude Code、Codex、Cline、Cursor、自研应用)只需把 Base URL 指向机柜,无需感知后端。
产品构成
| 层次 | 组成 |
|---|---|
| 机柜 | 8U 10 英寸机柜,托盘、理线、PDU、风道 |
| 算力 | 4×ASUS Ascent GX10(GB10,128GB 统一内存),TP4 集群 |
| 光互联 | 1×OpenMesh MV-4Q(4×400G QSFP-DD),2 根 400G→2×200G 分支线缆(每台 GX10 1 根 200G) |
| 管理 | 10GbE 管理交换机 + 网关主机 |
| 软件 | GLM-5.3 推理栈 + 多模型聚合词元管控平台!(AI-Router) |
TinyDC 机柜设计
8U 10 英寸机柜布局
MV-4Q 机身尺寸 213×330×45 mm(宽×深×高),正好为 1U 半宽,可直接装入 10 英寸机柜。GX10 尺寸约 150×150×51 mm,单台高于 1U,因此采用 3U 托盘每层叠放 2 台(2×51 mm 约 102 mm,小于 3U 的 133 mm),两层共 4 台。
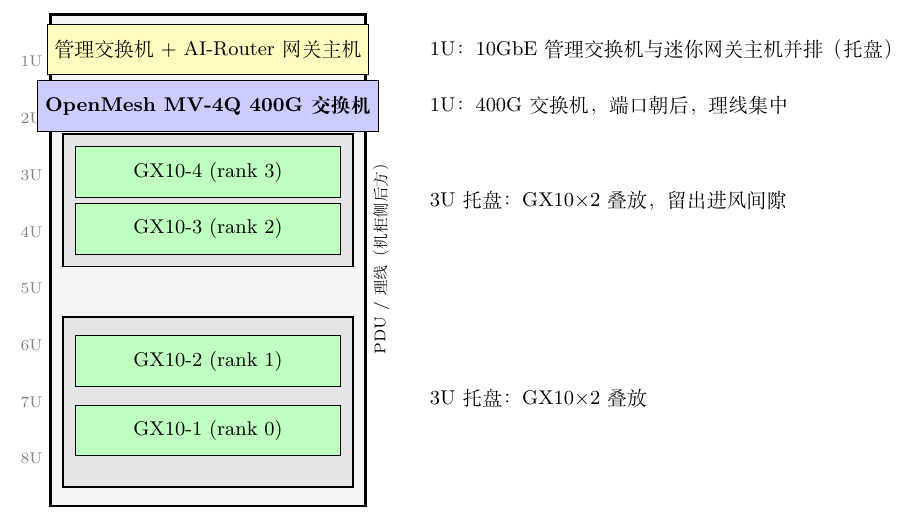
注意:GX10 采用 前后/侧向通风 ,托盘需开孔并在两台之间留 10 mm 以上间隙;机柜深度建议 ≥ 450 mm(MV-4Q 机身 330 mm,另需留出 QSFP-DD 线缆折弯空间)。以上为设计方案,具体尺寸需以实物与选定机柜核对。
功耗与散热估算
| 设备 | 数量 | 单台最大功耗(估算) |
|---|---|---|
| ASUS Ascent GX10 | 4 | 约 240 W(电源适配器规格) |
| OpenMesh MV-4Q | 1 | 以数据手册为准(取 150 W 设计余量) |
| 管理交换机 + 网关主机 | 1 | 约 50 W |
整柜峰值按 约 1.2 kW 设计,使用 1 路 10A/220V 即可;机柜顶部预留排风风扇,建议环境温度不超过 30°C。GX10 实际功耗以实测为准。
配置清单(BOM)
| 项目 | 数量 | 说明 |
|---|---|---|
| 8U 10 英寸机柜 | 1 | 含 2 个 3U 托盘、1 个 1U 托盘、PDU、理线 |
| ASUS Ascent GX10 | 4 | 128GB 统一内存,ConnectX-7,每台接 1×200G |
| OpenMesh MV-4Q | 1 | 4×400G QSFP-DD |
| 400G→2×200G 分支线缆 | 2 | DAC/AOC,每根接 2 台 GX10,长度按柜内走线选 1 m |
| 10GbE 管理交换机 | 1 | 8 口 |
| 网关主机 | 1 | 运行 AI-Router |
| 软件授权 | 1 | AI-Router 平台、GLM-5.3 部署与调优服务 |
核心交换机:OpenMesh MV-4Q
机柜内的核心交换机选用 OpenMesh MV-4Q 400G 数据中心交换机 ,为 4 台 GX10 提供 RoCE 无损互联底座:其 4 个 400G QSFP-DD 端口经通道化光模块可拆分为 8 个 200G 链路,本方案使用其中 2 个 400G 端口拆分为 4 个 200G,分别连接 4 台 GX10;PFC/ECN 保障 RDMA 流量无损,是本地 TP4 集群张量并行通信的关键。以下产品资料引自其规格文档。
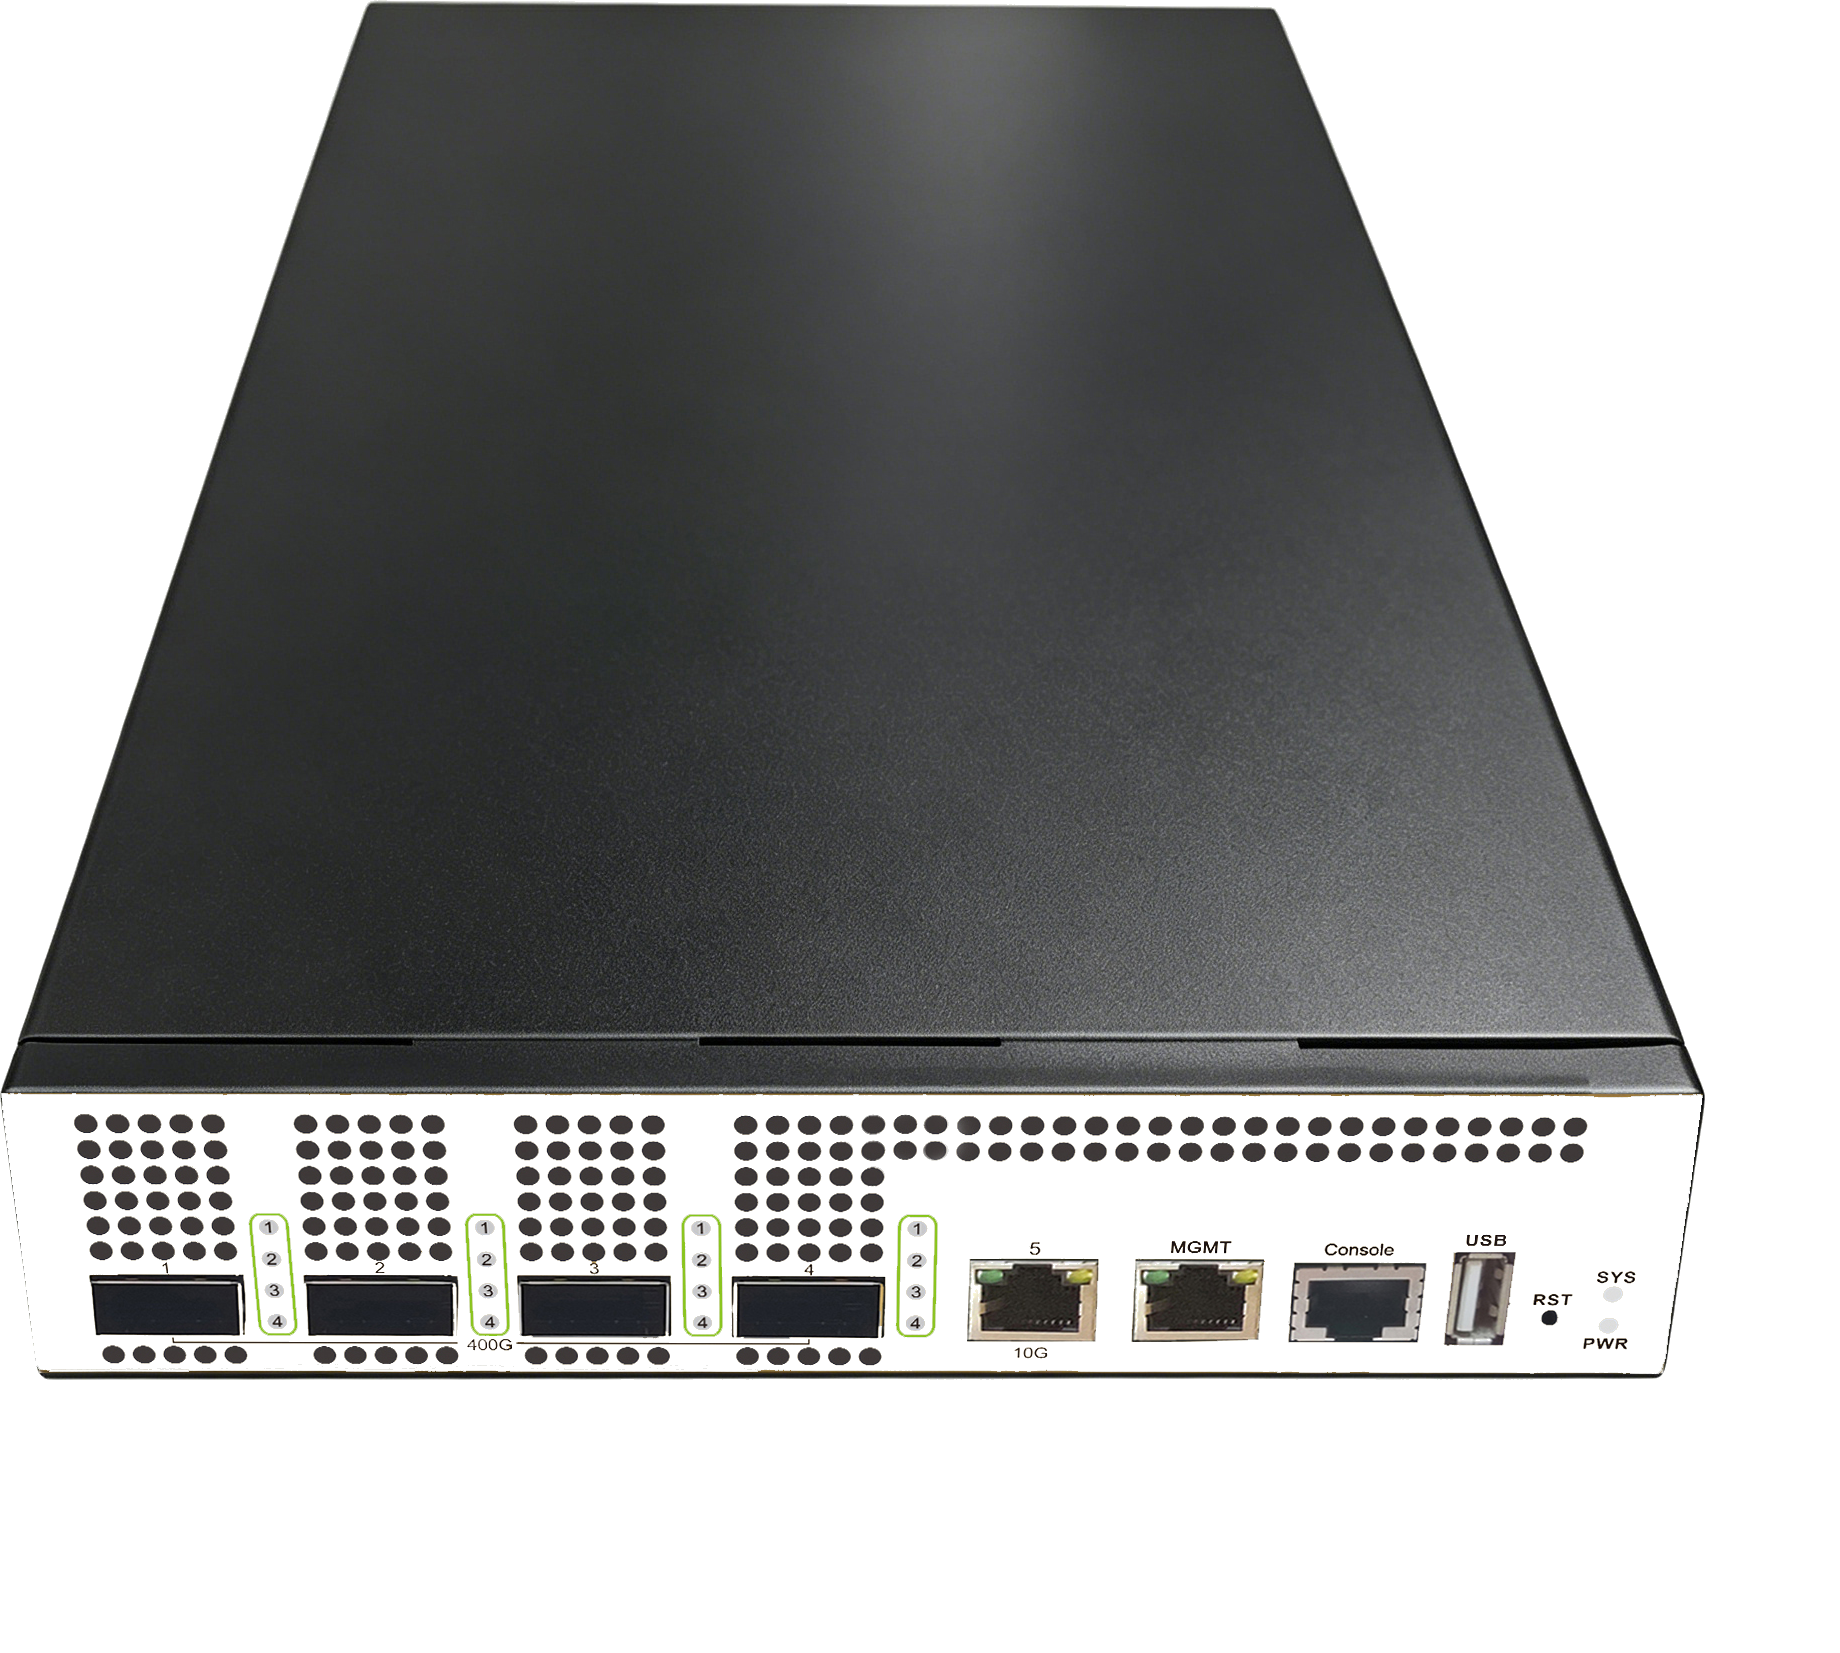
OpenMesh MV-4Q 400G数据中心交换机
产品概述 bmcol
OpenMesh MV-4Q 是面向新一代数据中心特别设计的 400G 数据中心交换机,定位于新一代数据中心 400G 汇聚的应用场景。该交换机支持丰富的数据中心特性,如 RoCE(PFC/ECN)、VXLAN、EVPN、NETCONF、Telemetry 等,为分布式计算、云计算等高性能业务场景提供高吞吐、高可靠、低时延的网络转发能力。
OpenMesh MV-4Q 支持 4 个 400G QSFP-DD 接口(通过通道化光模块可拆分为 2 个 200G 接口),支持 1 个插拔电源槽位,适用于 200G 与 400G 链路混合接入的组网场景。
特性和优势 ignoreheading
智能无损,提升高性能计算可靠性
数据中心网络中 RoCE 技术成为主流,为保证吞吐率,对丢包有严格要求,智能无损数据中心网络为分布式系统提供高吞吐、高可靠、低时延的转发能力。
支持 PFC 和 ECN 等技术,预判网络拥塞,快速反馈,减少网络丢包引起的重传和吞吐量下降,在时延和吞吐量之间取得最大收益。
支持动态负载均衡(DLB),基于 ECMP 组和 LAG 组进行动态负载均衡。
支持 RoCE 流量可视化,可对 RoCE 流量 KPI 进行分析,包括流量路径、RTT、吞吐量、丢包、异常会话、Top 会话等 QoS 指标,直观呈现网络各节点的 RoCE 网络拓扑以及智能无损数据中心网络的各种门限设置,从而更优地配置网络参数、更快地定位网络故障,提升运维效率。
VXLAN 实现数据中心网络扩展
将虚拟机发出的数据包封装在 UDP 中,并使用物理网络的 IP、MAC 地址作为外层头进行封装,在传统物理网络基础上构建逻辑的二层网络,极大降低了大二层网络对 VLAN 规格的需求,突破网络架构的束缚,支持多达 16M 用户进行隔离和标识,使大规模虚拟机迁移和异构虚拟迁移成为可能。支持静态 VXLAN 隧道、VXLAN 二层网关、VXLAN 三层网关、DCI 等功能。
EVPN 简化部署,自动化运维
传统自学习方式构建 VXLAN 需要人工手动配置隧道,配置复杂,地址同步需要依赖数据报文泛洪方式实现,产生大量泛洪报文,不适合大规模组网。EVPN 通过 MP-BGP 自动建立 VXLAN 隧道,自动同步 MAC 和 IP 地址,很好地解决了这些问题,同时支持多归属站点的主备备份,当同一站点通过多台 VTEP 接入 VXLAN 网络时,可避免单点故障。
高性能多核处理,丰富运维接口
OpenMesh MV-4Q 在业界首批采用多核 CPU,相比普通 CPU 性能提升数倍,可以更好地处理业务数据和 SDN/OpenFlow 流量。支持独立的带外管理网口,保证网络故障时还有冗余通道进行管理;支持外接 USB 大容量存储,方便进行软件升级、配置备份和日志记录;光口支持信号强度等信息读取,不需专业分析仪器即可对光模块和光纤进行诊断分析,所有端口均在交换机同一侧,大大简化布线。
领先的 VSF 虚拟化
通过 VSF 虚拟化技术实现整个虚拟化系统中设备间的信息共享及表项同步,整体性能及端口密度得到成倍增长,突破了传统网络结构中单台核心设备的性能及端口密度限制。通过 VSF 技术可实现跨设备链路聚合,在简化网络配置的同时提高网络连接的带宽和可靠性。VSF 虚拟化技术全面支持 IPv4、IPv6、MPLS 以及安全等特性。
广泛的适用场景
OpenMesh MV-4Q 的 4 个 400G 接口,可通过通道化 400G 光模块拆分为 8 个 200G 链路,适合 200G 与 400G 混合接入场景。
支持 MPLS/VPLS、MPLS VPN、IPv6 等园区网特性,亦适用于教育、政府、企业等园区网。MPLS VPN 和 VPLS VPN 实现了数据的安全分离,同时支持 MPLS VPN 访问公网功能,实现专网通信的同时可无障碍访问公网,保障业务的多样性。
采用业界先进的 ASIC 芯片实现 IPv6 线速转发,支持丰富的 IPv6 特性,特别是 IPv6 安全特性,支持 DHCPv6 Snooping、IPv6 SAVI 等功能,构建 IPv6 有序分址的安全网络,并提供丰富的隧道技术,实现全面稳定的 IPv6 过渡方案。
完善的运维管理与安全防护
支持云端管理,客户不需要单独部署本地网络管理系统,可远程对设备进行管理和配置,大大减少运维管理成本。
支持标准 802.1X 认证接入、扩展 802.1X 认证接入以及纯 Web Portal 认证接入等多种接入认证模式,网络安全可控。
具备丰富的监测网管功能,可实现任务异常、内存异常、交换芯片异常、CPU 利用率、堆栈异常等方面的监测;支持标准 SSH、SNMP v1/v2c/v3;Security IP 功能可拒绝非法配置员,只有合法 IP 才能对交换机进行配置管理,防止非法用户登录交换机。
多重可靠性保护,实现业务永续
支持多 IMG 冗余、多配置文件、VRRP/VRRPv3、MRPP 环网、BFD、GR 优雅重启、ULPP 上行链路检测等多种可靠性机制。
支持端口隔离、ARP 防扫描、ARP 限速、ARP Guard、ND Snooping、CPU 防护、基于芯片的防 DOS 攻击等安全特性,全面保障网络的稳定性和可靠性。
产品规格
硬件参数 MV-4Q 交换容量 3.2Tbps 包转发速率 810Mpps 端口形态 4个400G QSFP-DD端口(通过通道化光模块可拆分2个200G接口) 数据中心特性 支持RoCE v2(PFC,ECN) 支持VXLAN:静态隧道、VXLAN routing、VXLAN bridging、DCI等 支持EVPN:MP-BGP自动发现、协商、创建VXLAN隧道 支持MC-LAG:自动同步arp、mac,支持联动STP 支持Telemetry、Netconf、VSF设备虚拟化 电源 支持交流/直流电源模块 输入电压 额定电压范围:100V∼240V AC,50/60Hz 最大电压范围:90V∼264V AC,47/63Hz 物理尺寸mm(宽x深x高) 213x330x45mm 质量(Kg) 6Kg(满配1个可插拔AC电源) 工作温度 0-50
硬件与网络拓扑
设备清单
| 设备 | 数量 | 说明 |
|---|---|---|
| ASUS Ascent GX10 | 4 | GB10 Superchip,128GB 统一内存,ConnectX-7(200G),每台接 1 根 200G 线缆,ARM64 |
| OpenMesh MV-4Q | 1 | 4×400G QSFP-DD,每口可拆分为 2×200G,RoCE(PFC/ECN) |
| 400G→2×200G 分支线缆 | 2 | 1 端接交换机 400G 口,2 端分别接 2 台 GX10 各 1 个 200G 口 |
| 管理交换机 | 1 | GX10 的 10GbE RJ45 与路由器接入,承载管理、模型下载、API 流量 |
| 路由器主机 | 1 | 运行 AI-Router(可为小型 x86/ARM 主机或虚拟机) |
组网设计要点
- 每台主机 1 根 200G 线缆 :MV-4Q 的 端口 1、2 各配置为 2×200G 分拆模式,端口 1 接 GX10-1/2,端口 2 接 GX10-3/4; 端口 3、4 保持空闲 ,可用于上联核心网络、接入其他服务器或后续扩展(再接 2 台 GX10 或第二台交换机)。
- 单 rail 组网 :4 台 GX10 在同一 VLAN/子网(例如
10.10.1.0/24),NCCL 经单条 200G 链路做 RDMA all-reduce。参考项目按双 rail 验证性能, 单 rail 的 TP4 通信带宽减半 ,解码速度可能低于参考项目数据,需实测;部署时.env中仅填写一条 rail 的地址,并核对GLM_ROCE_ALLREDUCE在单 rail 下的行为。 - 管理与 API 走 GX10 的 10GbE 口,与数据面分离。
- 无损以太网 :交换机启用 PFC(优先级 3)+ ECN,DSCP 26 映射到无损队列;MTU 9216(主机 9000);NCCL 设置
NCCL_IB_TC=106、NCCL_IB_GID_INDEX指向 RoCEv2 GID。 - 参考项目要求:NCCL 2.30.7、固定的 v11 ARM64 镜像、每节点本地权重与 NVFP4 sidecar,并按 NVIDIA Sync 方式配置网络。
- 参考项目的管理口不对公网开放,API 只暴露路由器(带 Key 鉴权)。
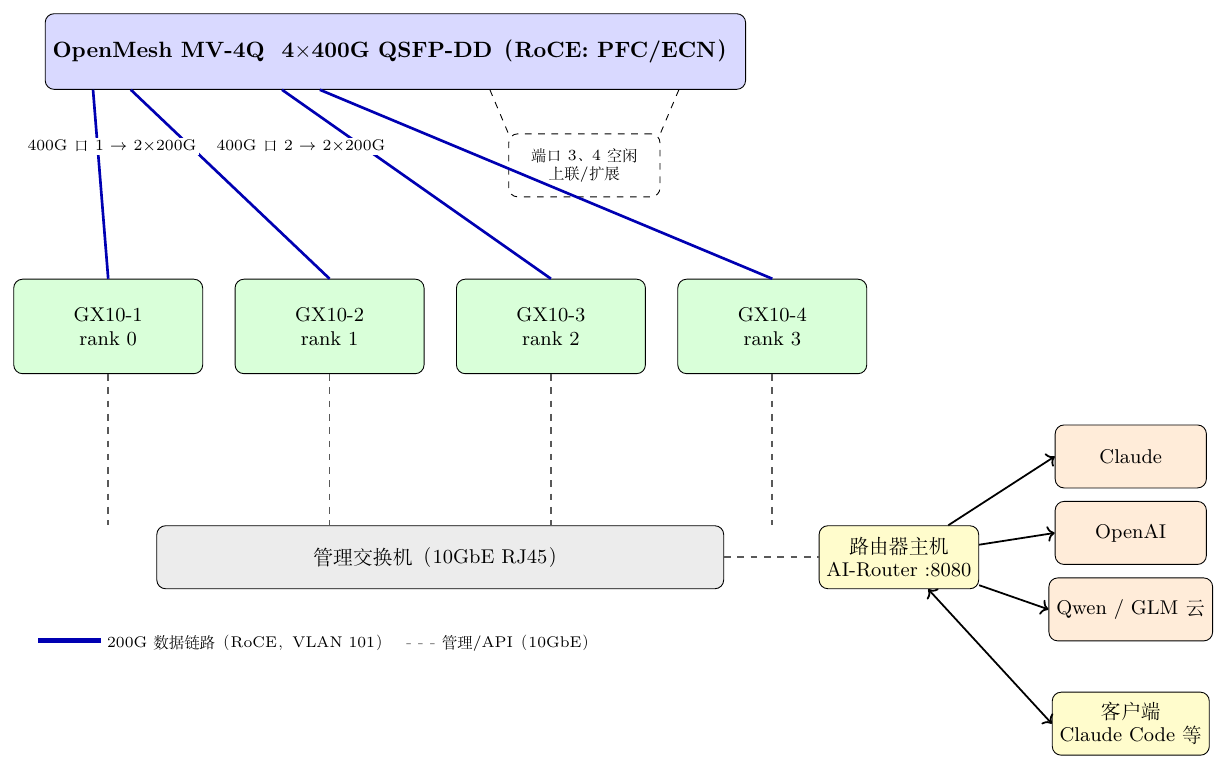
本地推理集群(GLM-5.3 TP4)
参考项目关键配置
| 项目 | 配置 |
|---|---|
| 模型 | 完整 GLM-5.3(753B),4 路张量并行,NVFP4 权重 sidecar |
| 上下文 | 262,144 tokens;共享 KV 池 264,640 tokens(FP4x KV) |
| 加速 | 原生 MTP 推测解码(K-stop)、前缀缓存、Marlin MoE L2 hint、Attention-front 融合 |
| 通信 | Switched RoCE,RDMA all-reduce( GLM_ROCE_ALLREDUCE=1 ;本方案为单 rail,需实测调整) |
| 服务 | vLLM;tool parser glm47 ,reasoning parser glm45 |
| 并发 | 4 个服务槽位,c8 时多余请求排队 |
性能预期(引自参考项目实测)
| 指标 | 数值 |
|---|---|
| 单流解码(thinking off) | prose 约 40,code 约 47,structured 约 50 tok/s |
| 4 并发聚合 | prose 约 66,code 约 72,structured 约 94 tok/s |
| 冷预填充 | 约 880–980 tok/s(32K 首 token 约 37 s) |
| 前缀缓存命中重放 | 8K 约 16,000 tok/s(agent 多轮对话受益明显) |
容量含义 :本地 GLM 适合 低并发、短到中等上下文 的场景;长上下文 agent 冷启动预填充较慢,且 4 个槽位易被占满。这正是需要路由器做 溢出控制 的原因:路由器对本地后端设置 max_inflight=4 ,超出后请求自动转到云端。
部署步骤摘要
git clone https://github.com/knapcio/GLM-5.3-4x-DGX-Spark-TP4 && cd GLM-5.3-4x-DGX-Spark-TP4
cp .env.example .env            # 填写 4 个主机、单条 rail 的地址、镜像 ID、路径、NCCL hash
bash overlay/guard/build_guard.sh
./start.sh l2hint-setup && ./start.sh attnfront-setup
DRY=1 ./start.sh serve && ./start.sh preflight && ./start.sh serve
curl http://GX10-1:8000/v1/models   # 验证 OpenAI 兼容接口
AI-Router 架构
逻辑架构
路由决策流程
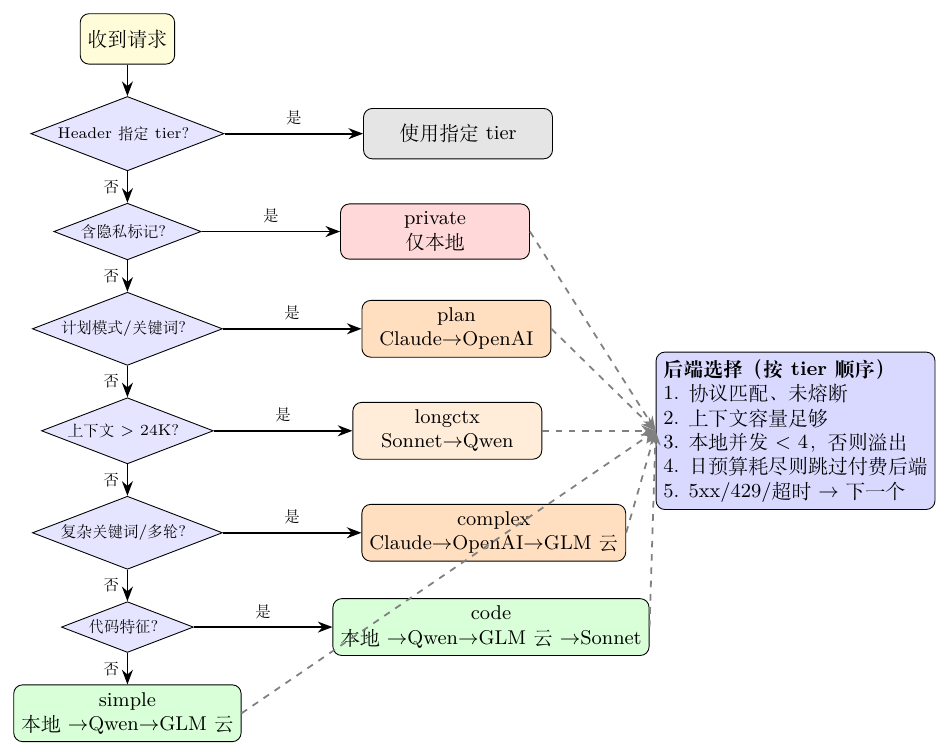
分级与后端映射
| Tier | 触发条件 | 后端优先顺序 | 目的 |
|---|---|---|---|
| private | 隐私标记(#private、机密) | 仅本地 GLM | 数据不出内网,不可溢出 |
| plan | Claude Code 计划模式;方案、架构、规划、评审、拆解 | Claude → OpenAI | 计划类质量最重要 |
| longctx | 输入超过 24K tokens | Sonnet → Qwen | 避免本地冷预填充过慢 |
| complex | 重构、根因、迁移;多轮达 12 轮以上 | Claude → OpenAI → GLM 云 | 高难度推理与多文件修改 |
| code | 代码块、报错、函数等特征 | 本地 → Qwen → GLM 云 → Sonnet | 常规编码低成本 |
| simple | 短文本无特征 | 本地 → Qwen → GLM 云 | 零成本优先 |
规则全部在 config.yaml 中配置,客户端也可用请求头 x-route-tier: plan 强制指定。每个响应带 x-router-backend/tier/reason 头,方便排查。
成本与容量控制
- 本地优先 :本地 GLM 无按 token 成本,分级中凡适合的都排在最前。
- 并发溢出 :本地
max_inflight=4(与 4 服务槽位一致),第 5 个并发请求自动转云端,避免排队。 - 日预算 :
daily_budget_usd到达后跳过付费后端(private 除外),降级到本地/低价后端。 - 熔断 :5xx 或超时摘除 30 s,429 摘除 5 s。
- 计量 :每次调用写入 SQLite(后端、tier、输入/输出 token、成本、耗时),
GET /stats查看。
多模型聚合词元管控平台(AI-Router)软件
功能
- 同时兼容 OpenAI
/v1/chat/completions与 Anthropic/v1/messages,流式 SSE 透传; - 协议保持原样转发给同协议后端(Qwen 与智谱均提供 Anthropic 兼容端点;vLLM 支持
/v1/messages),避免协议转换损耗工具调用; - 规则分类器(隐私/计划/复杂/代码/长上下文/简单),可扩展为小模型分类器(用本地 GLM 对请求打标);
- 故障转移、熔断、预算、并发限流、用量统计。
文件
| 文件 | 说明 |
|---|---|
tinydc/ai_router.py |
路由器主程序(FastAPI) |
tinydc/config.yaml |
后端、分级与规则配置 |
tinydc/requirements.txt |
依赖 |
运行
cd tinydc && python3 -m venv .venv && . .venv/bin/activate
pip install -r requirements.txt
export ROUTER_CLIENT_KEY=sk-tyum-xxx ANTHROPIC_API_KEY=... OPENAI_API_KEY=... \
       DASHSCOPE_API_KEY=... ZAI_API_KEY=...
uvicorn ai_router:app --host 0.0.0.0 --port 8080
客户端接入
# Claude Code
export ANTHROPIC_BASE_URL=http://router:8080
export ANTHROPIC_AUTH_TOKEN=sk-tyum-xxx

# OpenAI 兼容客户端(Codex、Cline、SDK)
export OPENAI_BASE_URL=http://router:8080/v1
export OPENAI_API_KEY=sk-tyum-xxx

# 强制走某个级别
curl http://router:8080/v1/chat/completions -H "x-route-tier: plan" ...
# 查看用量
curl http://router:8080/stats -H "x-api-key: sk-tyum-xxx"
配置文件
# AI-Router 配置示例。密钥通过环境变量注入,切勿写入文件。
listen: {host: 0.0.0.0, port: 8080}
client_keys: [${ROUTER_CLIENT_KEY}]       # 客户端访问路由器所用的 Key
db: ./usage.sqlite

backends:
  local-glm:                               # 4x GX10 TP4, vLLM
    openai_url:    http://10.10.0.10:8000/v1
    anthropic_url: http://10.10.0.10:8000      # vLLM /v1/messages
    key: EMPTY
    model: glm-5.3
    max_inflight: 4                        # 4 个服务槽位,超出即溢出
    max_context: 200000
    price: {in: 0, out: 0}
  claude:
    anthropic_url: https://api.anthropic.com
    key: ${ANTHROPIC_API_KEY}
    model: claude-opus-4-5
    price: {in: 15, out: 75}               # USD / 1M tokens
  claude-fast:
    anthropic_url: https://api.anthropic.com
    key: ${ANTHROPIC_API_KEY}
    model: claude-sonnet-4-5
    price: {in: 3, out: 15}
  openai:
    openai_url: https://api.openai.com/v1
    key: ${OPENAI_API_KEY}
    model: gpt-5
    price: {in: 1.25, out: 10}
  qwen:
    openai_url: https://dashscope.aliyuncs.com/compatible-mode/v1
    anthropic_url: https://dashscope.aliyuncs.com/apps/anthropic
    key: ${DASHSCOPE_API_KEY}
    model: qwen3-coder-plus
    price: {in: 1, out: 5}
  glm-cloud:
    openai_url: https://open.bigmodel.cn/api/paas/v4
    anthropic_url: https://open.bigmodel.cn/api/anthropic
    key: ${ZAI_API_KEY}
    model: glm-5.3
    price: {in: 0.6, out: 2.2}

# 分级:按顺序尝试,首个可用(健康且未过载)者胜出;其余为故障转移
tiers:
  private: [local-glm]                     # 含敏感标记,只允许本地
  simple:  [local-glm, qwen, glm-cloud]
  code:    [local-glm, qwen, glm-cloud, claude-fast]
  complex: [claude, openai, glm-cloud]
  plan:    [claude, openai]                # 计划/架构/评审类
  longctx: [claude-fast, qwen]             # 超出本地上下文

rules:
  private_markers: ["#private", "CONFIDENTIAL", "机密", "内部资料"]
  plan_keywords:   ["plan", "architecture", "design doc", "roadmap", "方案", "规划", "架构", "评审", "拆解"]
  complex_keywords: ["refactor", "root cause", "prove", "migrate", "重构", "根因", "复杂", "多文件"]
  code_markers:    ["```", "def ", "class ", "function", "traceback", "代码", "报错"]
  simple_max_tokens: 1500       # 估算输入 token 低于此值且无特征 → simple
  complex_min_tokens: 24000     # 大上下文倾向云端
  tools_min_for_complex: 12     # 工具/消息轮次很多的 agent 会话视为 complex
  header_override: x-route-tier # 客户端可强制指定 tier
  daily_budget_usd: 50          # 云端日预算;超出后降级到 local/qwen/glm
主程序
#!/usr/bin/env python3
"""AI-Router 多模型聚合词元光控平台(TinyDC Token-FREE): 按任务复杂度/成本/隐私在本地GLM与Claude/OpenAI/Qwen/GLM云之间路由。

入口(与官方 SDK 兼容):
  POST /v1/chat/completions   (OpenAI 协议)   -> 供 Codex/OpenAI SDK/Cline 等
  POST /v1/messages           (Anthropic 协议) -> 供 Claude Code (ANTHROPIC_BASE_URL)
  GET  /healthz  /stats
依赖: pip install fastapi uvicorn httpx pyyaml
运行: uvicorn ai_router:app --host 0.0.0.0 --port 8080
"""
import asyncio, json, os, re, sqlite3, time
from datetime import date
import httpx, yaml
from fastapi import FastAPI, Request, HTTPException
from fastapi.responses import JSONResponse, StreamingResponse

CFG_PATH = os.environ.get("AIROUTER_CONFIG", "config.yaml")

def load_cfg():
    raw = open(CFG_PATH, encoding="utf-8").read()
    raw = re.sub(r"\$\{(\w+)\}", lambda m: os.environ.get(m.group(1), ""), raw)
    return yaml.safe_load(raw)

CFG = load_cfg()
R = CFG["rules"]
BE = CFG["backends"]
inflight = {k: 0 for k in BE}
down_until = {k: 0.0 for k in BE}          # 熔断:失败后暂时摘除
client = httpx.AsyncClient(timeout=httpx.Timeout(600, connect=10))
db = sqlite3.connect(CFG.get("db", "usage.sqlite"), check_same_thread=False)
db.execute("""create table if not exists usage(ts real, day text, backend text, tier text,
  proto text, tin int, tout int, cost real, ms int, status int)""")
app = FastAPI(title="AI-Router")

# ---------------- 分类 ----------------
def text_of(body: dict) -> str:
    parts = []
    sysm = body.get("system")
    if isinstance(sysm, str): parts.append(sysm)
    elif isinstance(sysm, list): parts += [b.get("text", "") for b in sysm if isinstance(b, dict)]
    for m in body.get("messages", []):
        c = m.get("content")
        if isinstance(c, str): parts.append(c)
        elif isinstance(c, list):
            for b in c:
                if isinstance(b, dict):
                    parts.append(b.get("text") or json.dumps(b.get("input", ""), ensure_ascii=False)
                                 if b.get("type") != "tool_result" else str(b.get("content", ""))[:2000])
    return "\n".join(p for p in parts if p)

def est_tokens(s: str) -> int:     # 粗估:CJK 约 1 字/token,其余约 4 字符/token
    cjk = len(re.findall(r"[\u4e00-\u9fff]", s))
    return cjk + (len(s) - cjk) // 4

def last_user(body: dict) -> str:
    for m in reversed(body.get("messages", [])):
        if m.get("role") == "user":
            c = m.get("content")
            if isinstance(c, str): return c
            if isinstance(c, list):
                return " ".join(b.get("text", "") for b in c if isinstance(b, dict) and b.get("type") == "text")
    return ""

def classify(body: dict, hdr_tier: str | None):
    full, last = text_of(body), last_user(body)
    n = est_tokens(full)
    if hdr_tier in CFG["tiers"]: return hdr_tier, n, "header"
    if any(k.lower() in full.lower() for k in R["private_markers"]): return "private", n, "private-marker"
    # Claude Code 的 plan 模式会在系统提示中带 "plan mode"
    if re.search(r"plan mode|plan_mode|ExitPlanMode", full[:20000], re.I): return "plan", n, "plan-mode"
    ll = last.lower()
    if any(k.lower() in ll for k in R["plan_keywords"]): return "plan", n, "plan-keyword"
    if n > R["complex_min_tokens"]: return "longctx", n, "long-context"
    turns = len(body.get("messages", []))
    if any(k.lower() in ll for k in R["complex_keywords"]) or turns >= R["tools_min_for_complex"] \
       or len(body.get("tools", []) or []) > 0 and any(k in ll for k in ("多文件", "multi-file", "整个项目")):
        return "complex", n, "complex-keyword/turns"
    if any(k.lower() in full.lower() for k in R["code_markers"]): return "code", n, "code-marker"
    if n < R["simple_max_tokens"]: return "simple", n, "short"
    return "code", n, "default"

# ---------------- 选择后端 ----------------
def spent_today() -> float:
    r = db.execute("select coalesce(sum(cost),0) from usage where day=?", (str(date.today()),)).fetchone()
    return r[0]

def candidates(tier: str, proto: str, n: int):
    over = spent_today() >= R.get("daily_budget_usd", 1e9)
    out = []
    for name in CFG["tiers"][tier]:
        b = BE[name]
        if f"{proto}_url" not in b or time.time() < down_until[name]: continue
        if b.get("max_context", 10**9) < n + 4096: continue
        if inflight[name] >= b.get("max_inflight", 10**9): continue          # 本地过载 → 溢出
        paid = b["price"]["out"] > 0
        if over and paid and tier != "private": continue                      # 预算耗尽
        out.append(name)
    if not out and tier != "private":                                         # 兜底:任何协议匹配者
        out = [k for k, b in BE.items() if f"{proto}_url" in b and time.time() >= down_until[k]]
    return out

def headers_for(b, proto, req_headers):
    if proto == "anthropic":
        h = {"x-api-key": b["key"], "anthropic-version": req_headers.get("anthropic-version", "2023-06-01"),
             "content-type": "application/json"}
        if "anthropic-beta" in req_headers: h["anthropic-beta"] = req_headers["anthropic-beta"]
        return h
    return {"authorization": f"Bearer {b['key']}", "content-type": "application/json"}

def log(name, tier, proto, tin, tout, t0, status):
    p = BE[name]["price"]
    cost = (tin * p["in"] + tout * p["out"]) / 1e6
    db.execute("insert into usage values(?,?,?,?,?,?,?,?,?,?)",
               (time.time(), str(date.today()), name, tier, proto, tin, tout, cost, int((time.time()-t0)*1000), status))
    db.commit()

def usage_from(obj: dict):
    u = obj.get("usage") or {}
    return (u.get("input_tokens") or u.get("prompt_tokens") or 0,
            u.get("output_tokens") or u.get("completion_tokens") or 0)

# ---------------- 转发 ----------------
async def forward(request: Request, proto: str, path: str):
    auth = request.headers.get("x-api-key") or request.headers.get("authorization", "").removeprefix("Bearer ")
    if CFG.get("client_keys") and auth not in CFG["client_keys"]:
        raise HTTPException(401, "bad router key")
    body = await request.json()
    tier, n, why = classify(body, request.headers.get(R.get("header_override", "x-route-tier")))
    names = candidates(tier, proto, n)
    if not names: raise HTTPException(503, f"no backend for tier={tier} proto={proto}")
    stream = bool(body.get("stream"))
    last_err = None
    for name in names:                                                         # 故障转移
        b = BE[name]
        payload = dict(body); payload["model"] = b["model"]
        if proto == "openai" and stream:
            payload.setdefault("stream_options", {"include_usage": True})
        url = b[f"{proto}_url"].rstrip("/") + path
        hd = headers_for(b, proto, request.headers)
        rh = {"x-router-backend": name, "x-router-tier": tier, "x-router-reason": why}
        t0 = time.time(); inflight[name] += 1
        try:
            if not stream:
                r = await client.post(url, json=payload, headers=hd)
                inflight[name] -= 1
                if r.status_code >= 500 or r.status_code == 429:
                    down_until[name] = time.time() + (5 if r.status_code == 429 else 30)
                    last_err = r.status_code; continue
                try: tin, tout = usage_from(r.json())
                except Exception: tin = tout = 0
                log(name, tier, proto, tin or n, tout, t0, r.status_code)
                return JSONResponse(r.json(), status_code=r.status_code, headers=rh)
            req = client.build_request("POST", url, json=payload, headers=hd)
            r = await client.send(req, stream=True)
            if r.status_code >= 500 or r.status_code == 429:
                await r.aclose(); inflight[name] -= 1
                down_until[name] = time.time() + (5 if r.status_code == 429 else 30)
                last_err = r.status_code; continue

            async def gen(r=r, name=name, t0=t0):
                tin = tout = 0
                try:
                    async for line in r.aiter_lines():
                        if line.startswith("data:") and "usage" in line:
                            try:
                                a, o = usage_from(json.loads(line[5:]))
                                d = json.loads(line[5:]);
                                a2, o2 = usage_from(d.get("message", {})) if "message" in d else (0, 0)
                                tin = max(tin, a, a2); tout = max(tout, o, o2)
                            except Exception: pass
                        yield line + "\n"
                finally:
                    await r.aclose(); inflight[name] -= 1
                    log(name, tier, proto, tin or n, tout, t0, r.status_code)
            return StreamingResponse(gen(), status_code=r.status_code,
                                     media_type="text/event-stream", headers=rh)
        except (httpx.ConnectError, httpx.ReadTimeout, httpx.RemoteProtocolError) as e:
            inflight[name] = max(0, inflight[name] - 1)
            down_until[name] = time.time() + 30; last_err = str(e)
    raise HTTPException(502, f"all backends failed: {last_err}")

@app.post("/v1/chat/completions")
async def chat(request: Request): return await forward(request, "openai", "/chat/completions")

@app.post("/v1/messages")
async def messages(request: Request): return await forward(request, "anthropic", "/v1/messages")

@app.post("/v1/messages/count_tokens")
async def count(request: Request):
    body = await request.json()
    return {"input_tokens": est_tokens(text_of(body))}

@app.get("/healthz")
async def health():
    return {k: {"inflight": inflight[k], "down": max(0, int(down_until[k]-time.time()))} for k in BE}

@app.get("/stats")
async def stats():
    rows = db.execute("select day,backend,tier,count(*),sum(tin),sum(tout),round(sum(cost),4) "
                      "from usage group by 1,2,3 order by 1 desc limit 200").fetchall()
    return {"spent_today_usd": spent_today(),
            "rows": [dict(zip("day backend tier n tin tout usd".split(), r)) for r in rows]}
高级 Token 获取
路由器后端中的 Claude、OpenAI 等高级模型需要上游 Token。个人/小团队可直接注册使用,企业可自建中转托管。获取 Key 后填入 AI-Router 对应后端即可;BigToken 同时提供 Anthropic 与 OpenAI 接口,可直接作为 claude 、 openai 后端的 anthropic_url / openai_url 。
销售模式
我们针对不同使用规模提供两种方案。个人用户及小团队可直接使用 BigToken 中转服务;重度用户及企业客户可选择自建中转,并由我们负责建设和运维。
个人/小团队:直接使用中转服务
适合个人开发者、自由职业者及规模较小的团队,无需自行部署和维护服务,注册并配置 API Key 后即可使用。
- 开通简单 :无需准备服务器或搭建中转系统,可快速接入。
- 按需使用 :根据实际需求购买积分,无需承担额外的基础设施成本。
- 模型丰富 :通过统一接口使用 Claude、OpenAI 及其他主流模型。
- 维护省心 :平台负责线路、模型接口及服务的日常维护。
- 专属优惠 :购买积分前可联系我们领取折扣券,享受更优惠的价格。
如果这种方案适合您,可以直接通过 这里 注册。然后通过销售给的折扣券下单即可。(优于网站提供的折扣)
重度/企业级使用:自建中转托管服务
适合调用量较大、多人协作,或对系统独立性、模型选择、用量管理和服务稳定性有更高要求的客户。中转服务部署在客户自有或指定的基础设施中,可针对客户指定的模型进行建设,并由我们负责方案设计、部署及后续运维。
- 独立部署 :使用客户专属的中转环境,资源与其他用户隔离。
- 指定模型接入 :可根据业务需要,针对特定模型和上游渠道进行接入、配置与优化。
- 团队共享 :团队成员可通过统一的中转服务共享模型能力,无需分别采购和维护多个账号。
- 统一权限管理 :支持集中管理团队成员、API Key、访问权限及使用额度。
- 用量监控 :可按成员、API Key 或模型统计调用量及积分消耗,便于成本分析、预算控制和内部核算。
- 数据可控 :部署位置、日志保留及访问控制策略可按客户要求规划。
- 专业运维 :我们负责系统建设、升级、运行监控、故障处理及日常维护,客户无需组建专门的运维团队。
- 适合规模化使用 :可结合实际调用规模规划容量和线路,满足持续、高频的业务需求。
具体部署方式、服务范围及费用将根据客户的使用规模和技术要求单独评估,欢迎联系我们沟通。
中转使用介绍
如果无法正常使用,可以首先尝试翻墙,如翻墙后仍然无法使用,可以添加微信 bassTooyum 获得支持。
模型支持及费率
因为不同模型价格不同,我们提供的 积分 ,可以使用如下所列模型,不同的模型输出的token 消耗积分不同。 倍率越高意味着模型越贵,建议用户根据实际业务场景切换不同模型,实现效益最大化。
以Claude sonnet 5为例子, 如果购买2000万积分,那么实际最大可以用的 input token 为 20M/1.14 ,其它计算方法类似。
公开报价如下:
| 20M 积分 | 100M 积分 | 200M 积分 |
| 300¥ | 1459¥ | 2799¥ |
我们会在此公开价格基础上提供 折扣 ,并开具发票。
以下模型及倍率为截至 2026 年 10 月 8 日的参考列表,并非实时更新。实际支持的模型和计费倍率可能随上游渠道调整而变化,请以 BigToken 平台显示的信息为准。
Anthropic 接口
| 模型 | input | output | cache read | cache write |
|---|---|---|---|---|
| claude-fable-5.1 | 4.00 | 20.00 | 0.10 | 5.00 |
| claude-haiku-4-5-20251001 | 0.38 | 1.90 | 0.04 | 0.48 |
| claude-opus-4-8 | 1.90 | 9.52 | 0.19 | 2.38 |
| claude-opus-4-8-fast | 3.81 | 19.05 | 0.38 | 4.76 |
| claude-opus-5 | 1.90 | 9.52 | 0.19 | 2.38 |
| claude-opus-5-5 | 1.60 | 8.00 | 0.08 | 2.00 |
| claude-opus-5-5-fast | 3.20 | 16.00 | 0.16 | 4.00 |
| claude-sonnet-5 | 1.14 | 5.71 | 0.11 | 1.43 |
| claude-sonnet-5-5 | 0.80 | 4.00 | 0.08 | 1.00 |
OpenAI 接口
| 模型 | input | output | cache read | cache write |
|---|---|---|---|---|
| gpt-5.6-sol | 1.90 | 11.43 | 0.19 | 2.38 |
| gpt-6-astra | 4.00 | 20.00 | 0.40 | 5.00 |
| gpt-6-astra-flex | 2.00 | 10.00 | 0.20 | 2.50 |
| gpt-6-sol | 0.80 | 4.00 | 0.08 | 1.00 |
| gpt-6.1-sol | 0.80 | 4.00 | 0.04 | 1.00 |
| sub-gpt-5.6-luna | 0.57 | 1.96 | 0.03 | 0.40 |
| sub-gpt-5.6-sol | 2.86 | 49.02 | 0.83 | 10.21 |
| sub-gpt-5.6-terra | 1.43 | 12.26 | 0.20 | 2.56 |
| sub-gpt-6 | 4.00 | 16.00 | 16.00 | 16.00 |
| sub-gpt-image-2 | 4.00 | 16.00 | 16.00 | 16.00 |
| sub-gpt-image-2.5-sunburst | 2.00 | 8.00 | 8.00 | 8.00 |
其他模型
| 模型 | input | output | cache read | cache write |
|---|
实施与风险
| 阶段 | 内容 |
|---|---|
| 1 | 上架 GX10 与 MV-4Q,配置 VLAN、PFC/ECN、MTU,iperf/ibwritebw 验证每台 1×200G |
| 2 | 按参考项目部署 GLM-5.3 TP4,完成 preflight 与基准 |
| 3 | 部署 AI-Router,接入各云端 Key,灰度到部分用户 |
| 4 | 根据 /stats 调整分级规则与预算,必要时引入模型分类器 |
- 本地长上下文冷预填充慢 :>24K 走 longctx 云端。
- 本地仅 4 个槽位 :靠并发溢出缓解,用户量大时需增加节点或第二套集群。
- 显存余量小 :参考项目对每节点内存有严格水位线,建议专机专用,不运行其他负载。
- API Key 安全 :密钥仅通过环境变量注入;路由器对外必须启用 Key 鉴权并置于内网/VPN。
- 数据合规 :隐私标记仅为基础手段,企业部署应结合来源用户/项目维度做强制 private 策略。